

گوگل اخیراً چندین آزمایش خلاقانه در زمینه یادگیری ماشین را به نمایش گذاشت، از جمله Quick, Draw! که یک بازی است که در آن شما چیزی را میکشید و یک سیستم تشخیص تصویر حدس میزند که چیست. حالا این شرکت میلیونها نقاشی که بازیکنان ارسال کردهاند را به عنوان مجموعه دادهای باز برای توسعه دهندگان هوش مصنوعی منتشر میکند.
اگر فکر میکنید که مرور ۵۰ میلیون نقاشی بد از کلاه، کفش و گربه برای شما جذاب نیست، نگران نباشید! موضوع اصلی در اینجا مجموعه داده است. این نقاشیها از کشورهای مختلفی آمدهاند و بررسی تفاوتهای نقاشیهای مردم در کشورهایی مثل آلمان و کره، در مورد موضوعاتی مثل گربه یا صندلی، میتواند جذاب باشد!
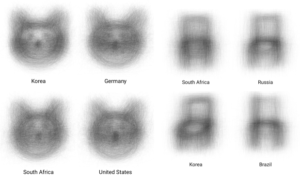
به طور مثال، چگونگی رسم صندلی توسط مردم کره و روسیه نشان میدهد که این دو گروه تمایل دارند صندلی را با زاویه یا به طور جانبی رسم کنند. چرا؟ این چیزی است که باید با سیستم یادگیری ماشین خودتان کشف کنید.
در واقع تفاوتهای جالبی وجود دارد. به عنوان مثال، در مجموعه داده گوگل یک تعصب به سمت کفشهای کتانی دیده میشود، به حدی که سیستم در تشخیص پاشنه بلند یا صندل با مشکل مواجه میشود. و گربهها چطور؟ قطعا راههای مختلفی برای رسم آنها وجود دارد. من خودم یک بار تمام بدن گربه را کشیدم. آیا من یک استثنا هستم؟ اگر فقط میدانستم چگونه یک سیستم یادگیری ماشین برای فهمیدن این موضوع ایجاد کنم!
گوگل پیشنهاد میدهد که از ابزار جدید Facets خود برای تجسم اطلاعات فراوان این مجموعه استفاده کنید. قسمت جالب این ماجرا اینجاست: وقتی مجموعه دادهای به این حجم – صدها میلیون مثال – دارید، چگونه آن را طبقهبندی کنید و حتی در سطح عمومی آن را رصد کنید تا افراد بتوانند الگوها و ایدههای عمومی را برای پیگیری پیدا کنند؟ و چگونه چیزهایی مثل تعصب سیستماتیک یا فرصتهای بهبود را تشخیص دهید؟
این ۵۰ میلیون نقاشی تنها آغاز کار است – حدود ۷۵۰ میلیون نقاشی دیگر به مرور زمان منتشر خواهد شد و احتمالا اطلاعات جالب از پروژههای دیگر نیز انتشار خواهد یافت. به وبلاگ Google Research (یا TechCrunch، بدیهی است) برای مطلع شدن از جدیدترین اطلاعات چشم بدوزید.