

غوغل
عرضت غوغل مؤخرًا بعض تجاربها الرائعة في مجال التعلم الآلي، ومن بينها Quick, Draw! وهي لعبة تقوم فيها برسم شيء ما ويحاول نظام التعرف على الصور تخمين ما هو. الآن تطلق الشركة ملايين الرسومات التي أرسلها اللاعبون كمجموعة بيانات مفتوحة لمطوري الذكاء الاصطناعي للعب بها.
الآن، إذا لم تكن فكرة تصفح مجموعة (أتكلم عن 50 مليونًا هنا) من الرسومات السيئة للقبعات والأحذية والقطط تبدو ممتعة بالنسبة لك، فلا تقلق! ليس هذا هو الهدف الحقيقي. الأمر يتعلق حقًا بالبيانات الوصفية. جاءت هذه الرسومات من العديد من البلدان المختلفة، ومن الممتع التحقق من مدى اختلاف طريقة تفكير ألمانيا وكوريا، على سبيل المثال، حول القطط. أو الكراسي! حسنًا، انظر، هناك أنماط تستحق الفحص. من الواضح أن رسامي كوريا وروسيا كانوا أكثر عرضة لرسم الكرسي بزاوية أو بشكل جانبي. لماذا؟ هذا ما يجب أن تكتشفه بنفسك باستخدام نظام التعلم الآلي الخاص بك! هناك في الواقع الكثير من الاختلافات المثيرة للاهتمام. كما تشير مشاركة غوغل، ظهر تحيز نحو حذاء رياضي، لدرجة أن النظام سيواجه صعوبة في التعرف على كعب عالٍ أو صندل. ماذا عن القطط؟ بالتأكيد هناك فئات فرعية للطريقة التي اختار الناس رسمها بها. أعتقد أنني رسمت واحدة بالفعل، ورسمت القطة بأكملها. هل أنا استثناء غريب ووسيم؟ لو فقط كنت أعرف كيفية إنشاء نظام تعلم آلي لمعرفة ذلك (تلميح). تقترح غوغل عليك استخدام أداة Facets الجديدة الخاصة بهم لتصور كمية البيانات الضخمة الموجودة في المجموعة.
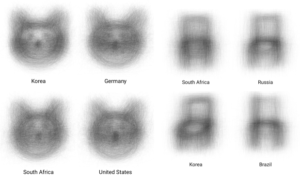
وهذا هو الجزء المثير للاهتمام حقًا في كل هذا. عندما يكون لديك مجموعات بيانات بهذا الحجم – بمئات الملايين من الأمثلة – كيف يمكنك فرزها وملاحظتها حتى على مستوى عام بحيث يمكن للأشخاص العثور على أنماط عامة وأفكار تستحق المتابعة؟ وكيف يمكنك اكتشاف أشياء مثل التحيزات المنهجية أو فرص التحسين؟
تعتبر 50 مليون رسمة مجرد بداية – سيتم إصدار 750 مليون رسمة أخرى على مدى الوقت، ومن المفترض أن يتم إصدار بيانات مثيرة للاهتمام من مشاريع أخرى أيضًا. ابق عينك على مدونة بحث غوغل (أو TechCrunch، بطبيعة الحال) للحصول على أحدث المعلومات.